imports

import tensorflow as tf
import tensorflow.experimental.numpy as tnp
tnp.experimental_enable_numpy_behavior()
import matplotlib.pyplot as plt
import numpy as np
tf.config.experimental.list_physical_devices()
[PhysicalDevice(name='/physical_device:CPU:0', device_type='CPU'),
 PhysicalDevice(name='/physical_device:GPU:0', device_type='GPU')]
%load_ext tensorboard

CNN

CONV의 역할

- 데이터생성 (그냥 흑백대비 데이터)

_X1 = tnp.ones([50,25])*10 
_X1
<tf.Tensor: shape=(50, 25), dtype=float64, numpy=
array([[10., 10., 10., ..., 10., 10., 10.],
       [10., 10., 10., ..., 10., 10., 10.],
       [10., 10., 10., ..., 10., 10., 10.],
       ...,
       [10., 10., 10., ..., 10., 10., 10.],
       [10., 10., 10., ..., 10., 10., 10.],
       [10., 10., 10., ..., 10., 10., 10.]])>
_X2 = tnp.zeros([50,25])*10 
_X2
<tf.Tensor: shape=(50, 25), dtype=float64, numpy=
array([[0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       ...,
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.],
       [0., 0., 0., ..., 0., 0., 0.]])>
tf.concat([_X1,_X2],axis=1)
<tf.Tensor: shape=(50, 50), dtype=float64, numpy=
array([[10., 10., 10., ...,  0.,  0.,  0.],
       [10., 10., 10., ...,  0.,  0.,  0.],
       [10., 10., 10., ...,  0.,  0.,  0.],
       ...,
       [10., 10., 10., ...,  0.,  0.,  0.],
       [10., 10., 10., ...,  0.,  0.,  0.],
       [10., 10., 10., ...,  0.,  0.,  0.]])>
plt.imshow(tf.concat([_X1,_X2],axis=1),cmap='gray')
<matplotlib.image.AxesImage at 0x7fdb88415000>
_noise = tnp.random.randn(50*50).reshape(50,50)
_noise
<tf.Tensor: shape=(50, 50), dtype=float64, numpy=
array([[-0.51170252,  0.44488448, -0.37768718, ...,  0.31721451,
        -2.51327619,  0.52484648],
       [-0.4941939 , -1.09514349,  1.25396721, ..., -0.23194   ,
        -0.71051373, -0.69419095],
       [-0.45022513, -2.02717269,  0.92595479, ...,  1.78765173,
         0.14056303,  0.520452  ],
       ...,
       [-0.14080382, -2.29286879, -0.80367313, ..., -0.59715722,
         0.54068818,  1.93618727],
       [-1.03439842, -0.940278  ,  0.73305531, ..., -0.62282159,
         1.45165231,  0.66823899],
       [-3.05820828,  0.85240415,  0.72343724, ...,  1.09404843,
         1.23579105,  1.3008287 ]])>
XXX = tf.concat([_X1,_X2],axis=1) + _noise
XXX=XXX.reshape(1,50,50,1) # conv를 위해 shape을 맞춰주었다.
plt.imshow(XXX.reshape(50,50),cmap='gray')
<matplotlib.image.AxesImage at 0x7fdb88463be0>

- conv layer 생성

conv = tf.keras.layers.Conv2D(2,(2,2)) 
conv.weights # 처음에는 가중치가 없음 
[]
conv(XXX) # 가중치를 만들기 위해서 XXX를 conv에 한번 통과시킴
conv.weights # 이제 가중치가 생김
[<tf.Variable 'conv2d/kernel:0' shape=(2, 2, 1, 2) dtype=float32, numpy=
 array([[[[-0.45586333, -0.1047467 ]],
 
         [[ 0.6862492 , -0.4972797 ]]],
 
 
        [[[-0.13820118,  0.20424747]],
 
         [[ 0.3288589 , -0.11026746]]]], dtype=float32)>,
 <tf.Variable 'conv2d/bias:0' shape=(2,) dtype=float32, numpy=array([0., 0.], dtype=float32)>]

- 가중치의 값을 확인해보자.

conv.weights[0] # kernel에 해당하는것 
<tf.Variable 'conv2d/kernel:0' shape=(2, 2, 1, 2) dtype=float32, numpy=
array([[[[-0.45586333, -0.1047467 ]],

        [[ 0.6862492 , -0.4972797 ]]],


       [[[-0.13820118,  0.20424747]],

        [[ 0.3288589 , -0.11026746]]]], dtype=float32)>
conv.weights[1] # bias에 해당하는것 
<tf.Variable 'conv2d/bias:0' shape=(2,) dtype=float32, numpy=array([0., 0.], dtype=float32)>

bias가 2개 들어가있네!

w1 참고 그림

- 필터값을 원하는 것으로 변경해보자.

w0 = [[0.25,0.25],[0.25,0.25]] # 잡티를 제거하는 효과를 준다. (평균이 되니까!)
w1 = [[-1.0,1.0],[-1.0,1.0]] # 경계를 찾기 좋아보이는 필터이다. (엣지검출)
np.array(w0).reshape(2,2,1,1)
array([[[[0.25]],

        [[0.25]]],


       [[[0.25]],

        [[0.25]]]])
np.array(w1).reshape(2,2,1,1)
array([[[[-1.]],

        [[ 1.]]],


       [[[-1.]],

        [[ 1.]]]])
w=np.concatenate([np.array(w0).reshape(2,2,1,1),np.array(w1).reshape(2,2,1,1)],axis=-1)
w
array([[[[ 0.25, -1.  ]],

        [[ 0.25,  1.  ]]],


       [[[ 0.25, -1.  ]],

        [[ 0.25,  1.  ]]]])
b= np.array([0.0,0.0])
b
array([0., 0.])
conv.set_weights([w,b])
conv.get_weights()
[array([[[[ 0.25, -1.  ]],
 
         [[ 0.25,  1.  ]]],
 
 
        [[[ 0.25, -1.  ]],
 
         [[ 0.25,  1.  ]]]], dtype=float32),
 array([0., 0.], dtype=float32)]
  • 첫번째는 평균을 구하는 필터,
  • 두번째는 엣지를 검출하는 필터

- 필터를 넣은 결과를 확인

채널 2개(1,49,49,2) 나오니까 나눠서 보자

XXX0=conv(XXX)[...,0] # 채널0
XXX0
<tf.Tensor: shape=(1, 49, 49), dtype=float32, numpy=
array([[[ 9.5859613e+00,  1.0056505e+01,  1.0326652e+01, ...,
          5.6875817e-02, -7.8462887e-01, -8.4828353e-01],
        [ 8.9833164e+00,  9.7644024e+00,  1.0720357e+01, ...,
          4.0478933e-01,  2.4644026e-01, -1.8592241e-01],
        [ 9.5075359e+00,  9.6883612e+00,  1.0516663e+01, ...,
          8.2350314e-02,  2.6497537e-01,  4.3067247e-01],
        ...,
        [ 9.3961983e+00,  9.1817837e+00,  9.9334126e+00, ...,
         -2.5907221e-01, -9.5353723e-03,  4.6619147e-01],
        [ 8.8979130e+00,  9.1740589e+00,  1.0204453e+01, ...,
          2.3932981e-01,  1.9309041e-01,  1.1491916e+00],
        [ 8.9548798e+00,  1.0342155e+01,  1.0008765e+01, ...,
          1.7812608e-01,  7.8966755e-01,  1.1641278e+00]]], dtype=float32)>
XXX1=conv(XXX)[...,1] # 채널1
XXX1
<tf.Tensor: shape=(1, 49, 49), dtype=float32, numpy=
array([[[ 0.35563755,  1.5265388 , -0.44595432, ..., -0.05695425,
         -3.3090644 ,  3.0544453 ],
        [-2.177897  ,  5.302238  , -1.4784145 , ...,  1.4922662 ,
         -2.1256626 ,  0.39621174],
        [-4.14058   ,  4.8638835 , -1.5506802 , ...,  1.1737798 ,
         -0.44327974,  1.1060681 ],
        ...,
        [-1.7283144 ,  0.8706579 ,  2.1358538 , ...,  2.2917542 ,
         -1.2936069 ,  3.1965141 ],
        [-2.0579443 ,  3.162529  ,  0.9590483 , ..., -3.3972769 ,
          3.2123194 ,  0.6120858 ],
        [ 4.004733  ,  1.5443659 , -2.877925  , ...,  0.2299493 ,
          2.2162166 , -0.7183757 ]]], dtype=float32)>

- 각 채널을 시각화

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2)
ax1.imshow(XXX.reshape(50,50),cmap='gray')
<matplotlib.image.AxesImage at 0x7fdb8828a5c0>
ax3.imshow(XXX0.reshape(49,49),cmap='gray')
<matplotlib.image.AxesImage at 0x7fdb88552470>
ax4.imshow(XXX1.reshape(49,49),cmap='gray')
<matplotlib.image.AxesImage at 0x7fdb88289d50>
fig
  • 2사분면: 원래이미지
  • 3사분면: 원래이미지 -> 평균을 의미하는 conv적용
  • 4사분면: 원래이미지 -> 엣지를 검출하는 conv적용

- conv(XXX)의 각 채널에 한 번 더 conv를 통과시켜보자

XXX0.shape, XXX1.shape
(TensorShape([1, 49, 49]), TensorShape([1, 49, 49]))
conv(XXX0.reshape(1,49,49,1))[...,0] ### XXX0 -> 평균필터 <=> XXX -> 평균필터 -> 평균필터 
conv(XXX0.reshape(1,49,49,1))[...,1] ### XXX0 -> 엣지필터 <=> XXX -> 평균필터 -> 엣지필터 
conv(XXX1.reshape(1,49,49,1))[...,0] ### XXX1 -> 평균필터 <=> XXX -> 엣지필터 -> 평균필터 
conv(XXX1.reshape(1,49,49,1))[...,1] ### XXX1 -> 엣지필터 <=> XXX -> 엣지필터 -> 엣지필터 
<tf.Tensor: shape=(1, 48, 48), dtype=float32, numpy=
array([[[  8.651036  ,  -8.753145  ,   2.0467367 , ...,   1.7177694 ,
          -6.870039  ,   8.885384  ],
        [ 16.484598  , -13.195216  ,   5.1244392 , ...,   2.4541578 ,
          -5.234988  ,   4.0712223 ],
        [ 13.650472  , -10.372585  ,   4.8081884 , ...,  -4.5104175 ,
           0.12856537,   1.5617114 ],
        ...,
        [  0.2099638 ,   4.598176  ,   0.42708588, ...,  14.179796  ,
         -14.57027   ,  13.218005  ],
        [  7.8194456 ,  -0.9382849 ,  -3.1723719 , ...,  -0.36768866,
           3.0242352 ,   1.8898873 ],
        [  2.760106  ,  -6.6257715 ,   2.1411648 , ...,  -4.7194347 ,
           8.595863  ,  -5.534826  ]]], dtype=float32)>
fig,ax =plt.subplots(3,4)
ax[0][0].imshow(XXX.reshape(50,50),cmap='gray') # 원래 이미지
<matplotlib.image.AxesImage at 0x7fdb80111d80>
ax[1][0].imshow(XXX0.reshape(49,49),cmap='gray') # 원래 이미지 -> 평균필터 
ax[1][2].imshow(XXX1.reshape(49,49),cmap='gray') # 원래 이미지 -> 엣지필터
<matplotlib.image.AxesImage at 0x7fdb884aeb00>
ax[2][0].imshow(conv(XXX0.reshape(1,49,49,1))[...,0].reshape(48,48),cmap='gray') # 원래이미지 -> 평균필터 
ax[2][1].imshow(conv(XXX0.reshape(1,49,49,1))[...,1].reshape(48,48),cmap='gray') # 원래이미지 -> 엣지필터
ax[2][2].imshow(conv(XXX1.reshape(1,49,49,1))[...,0].reshape(48,48),cmap='gray') # 원래이미지 -> 평균필터 
ax[2][3].imshow(conv(XXX1.reshape(1,49,49,1))[...,1].reshape(48,48),cmap='gray') # 원래이미지 -> 엣지필터
<matplotlib.image.AxesImage at 0x7fdb80111c90>
fig.set_figheight(8)
fig.set_figwidth(16)
fig.tight_layout()
fig

평균 두 번 했더니 희미해지는 거 같아

엣지 두 번하는 것은 의미 없는 것 같아

- 요약

  • conv의 weight에 따라서 엣지를 검출하는 필터가 만들어지기도 하고 스무딩의 역할을 하는 필터가 만들어지기도 한다. 그리고 우리는 의미를 알 수 없지만 어떠한 역할을 하는 필터가 만들어질 것이다.
  • 이것들을 조합하다보면 우연히 이미지를 분류하기에 유리한 특징을 뽑아내는 weight가 맞춰질 수도 있겠다.
  • 채널수를 많이 만들고 다양한 웨이트조합을 실험하다보면 보다 복잡한 이미지의 특징을 추출할 수도 있을 것이다?
  • 컨볼루션 레이어의 역할 = 이미지의 특징을 추출하는 역할
XXX.shape
TensorShape([1, 50, 50, 1])
plt.imshow(conv(XXX.reshape(50,50).T.reshape(1,50,50,1))[...,1].reshape(49,49))
<matplotlib.image.AxesImage at 0x7fdb241814e0>
plt.imshow(conv(XXX.reshape(50,50).T.reshape(1,50,50,1))[...,0].reshape(49,49))
<matplotlib.image.AxesImage at 0x7fdb241c26e0>
  • 경계 없는 거랑 있는 거랑은 값을 다 더해서 큰 것만 골라내는 법으로 찾을 수 있음
  • 필터를 다르게 설정하면 경계를 다르게 가진 이미지를 구분해낼 수 있다.
    • 경계가 위처럼 등장할 것이니까!
    • 하지만 모든 필터가 이렇게 경계를 구분해 내는 것은 아니야, 우리는 기대를 할 뿐, 그 경계를 찾을 것이라는

- 참고: 스트라이드, 패딩

  • 스트라이드: 윈도우가 1칸씩 이동하는 것이 아니라 2~3칸씩 이동함
  • 패딩: 이미지의 가장자리에 정당한 값을 넣어서 (예를들어 0) 컨볼루션을 수행. 따라서 컨볼루션 연산 이후에도 이미지의 크기가 줄어들지 않도록 방지한다.

MAXPOOL

- 기본적역할: 이미지의 크기를 줄이는 것

  • 이미지의의 크기를 줄여야하는 이유? 어차피 최종적으로 10차원으로 줄어야하므로
  • 이미지의 크기를 줄이면서도 동시에 아주 크리티컬한 특징은 손실없이 유지하고 싶다~

이미지 크기를 줄여서 계산 덜 하게 하자( 더 빨리 돌아가게, 더 효율적으로)

- 점점 작은 이미지가 되면서 중요한 특징들은 살아남지만 그렇지 않으면 죽는다. (캐리커쳐 느낌)

- 평균이 아니라 max를 쓴 이유는? 그냥 평균보다 나을것이라고 생각했음..

  • 그런데 사실은 꼭 그렇지만은 않아서 최근에는 꼭 맥스풀링을 고집하진 않는 추세 (평균풀링도 많이씀)

특징을 압축하고, ..압축하고..

컴퓨터가 weight를 자동으로 찾는 maxpooling

CNN 아키텍처의 표현방법

- 아래와 같이 아키텍처의 다이어그램 형태로 표현하고 굳이 노드별로 이미지를 그리진 않음

- 물론 아래와 같이 그리는 경우도 있음
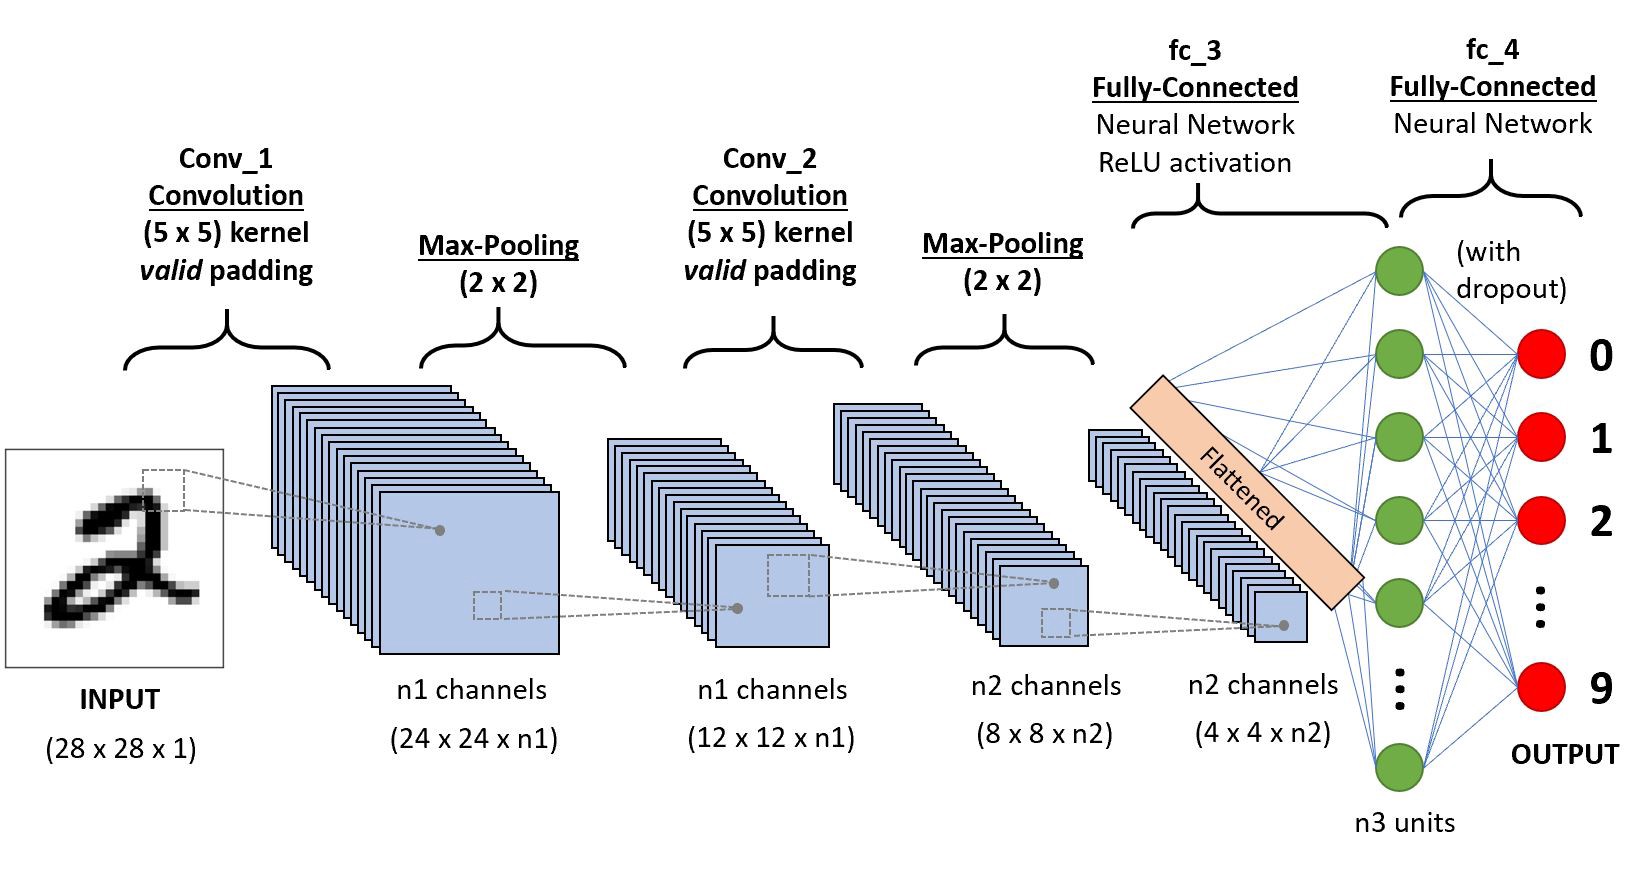
Discusstion about CNN

- 격자형태로 배열된 자료를 처리하는데 특화된 신경망이다.

  • 시계열 (1차원격자), 이미지 (2차원격자)

- 실제응용에서 엄청난 성공을 거두었다.

- 이름의 유래는 컨볼루션이라는 수학적 연산을 사용했기 때문

  • 컨볼루션은 조금 특별한 선형변환이다.

convolution neural network

- 신경과학의 원리가 심층학습에 영향을 미친 사례이다.

CNN의 모티브

- 희소성 + 매개변수의 공유

  • 다소 철학적인 모티브임
  • 희소성: 이미지를 분석하여 특징을 뽑아낼때 부분부분의 특징만 뽑으면 된다는 의미
  • 매개변수의 공유: 한 채널에는 하나의 역할을 하는 커널을 설계하면 된다는 의미 (스무딩이든 엣징이든). 즉 어떤지역은 스무딩, 어떤지역은 엣징을 할 필요가 없이 한채널에서는 엣징만, 다른채널에서는 스무딩만 수행한뒤 여러채널을 조합해서 이해하면 된다.

DNN에서는 픽셀마다 weight가 다 걸리니까 어느 부분에서 스무딩했는지, 엣징했는지 DNN의 출력결과를 통해 알아낼 수 있다.

- 매개변수 공유효과로 인해서 파라메터가 확 줄어든다.

(예시) (1,6,6,1) -> (1,5,5,2)

  • MLP방식이면 (36,50) 의 차원을 가진 매트릭스가 필요함 => 1800개의 매개변수 필요
  • CNN은 8개의 매개변수 필요

CNN 신경망의 기본구조

- 기본유닛

  • conv - activation - pooling
  • conv - conv - activation - pooling

모형의 성능을 올리기 위한 노력들

dropout

- 아래의 예제를 복습하자.

np.random.seed(43052)
x = np.linspace(0,1,100).reshape(100,1)
y = np.random.normal(loc=0,scale=0.01,size=(100,1))
plt.plot(x,y)
[<matplotlib.lines.Line2D at 0x7fdb2402dcc0>]

추정값이 직선이 나와서 이미 오버피팅이 예상되는 상태

tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(2048,activation='relu'))
net.add(tf.keras.layers.Dense(1))
net.compile(loss='mse',optimizer='adam')
net.fit(x,y,epochs=5000,verbose=0,batch_size=100)
<keras.callbacks.History at 0x7fdaf84544f0>
plt.plot(x,y)
plt.plot(x,net(x),'--')
[<matplotlib.lines.Line2D at 0x7fdaf83547c0>]

- train/test로 나누어서 생각해보자.

tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(2048,activation='relu'))
net.add(tf.keras.layers.Dense(1))
net.compile(loss='mse',optimizer='adam')
net.fit(x[:80],y[:80],epochs=5000,verbose=0,batch_size=80)
<keras.callbacks.History at 0x7fdaf839cfa0>
plt.plot(x,y)
plt.plot(x[:80],net(x[:80]),'--')
[<matplotlib.lines.Line2D at 0x7fdaf839e1d0>]
plt.plot(x,y)
plt.plot(x[:80],net(x[:80]),'--')
plt.plot(x[80:],net(x[80:]),'--')
[<matplotlib.lines.Line2D at 0x7fdaf851b730>]

오버피팅의 전형적안 예시

train, val-test 나눈다?

  • 조금 훈련하고 예측해보고 조금 훈련하고 예측해보고 이런 식!
  • train에서 추세를 따라가는게 좋은게 아니다 $\to$ 그냥 직선으로 핏하는거 이외에는 다 오버핏이다.

- 매 에폭마다 적당히 80%의 노드들을 빼고 학습하자 $\to$ 너무 잘 학습되는 문제는 생기지 않을 것이다 (과적합이 방지될것이다?)

tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(2048,activation='relu'))
net.add(tf.keras.layers.Dropout(0.8))
net.add(tf.keras.layers.Dense(1))
net.compile(loss='mse',optimizer='adam')
net.fit(x[:80],y[:80],epochs=5000,verbose=0,batch_size=80)
<keras.callbacks.History at 0x7fdaf8154370>
plt.plot(x,y)
plt.plot(x[:80],net(x[:80]),'--')
plt.plot(x[80:],net(x[80:]),'--')
[<matplotlib.lines.Line2D at 0x7fdaf816c100>]

- 드랍아웃에 대한 summary

  • 직관: 특정노드를 랜덤으로 off시키면 학습이 방해되어 오히려 과적합이 방지되는 효과가 있다 (그렇지만 진짜 중요한 특징이라면 랜덤으로 off 되더라도 어느정도는 학습될 듯)
  • note: 드랍아웃을 쓰면 오버핏이 줄어드는건 맞지만 완전히 없어지는건 아니다.
  • note: 오버핏을 줄이는 유일한 방법이 드랍아웃만 있는것도 아니며, 드랍아웃이 오버핏을 줄이는 가장 효과적인 방법도 아니다 (최근에는 dropout보다 batch nomalization을 사용하는 추세임)

중요한 특징은 이렇게 몇 개 빼고 해도 잘 나타날걸???

train / val / test

- data

(x_train, y_train), (x_test, y_test) = tf.keras.datasets.fashion_mnist.load_data()
X= x_train.reshape(-1,28,28,1)/255 ## 입력이 0~255 -> 0~1로 표준화 시키는 효과 + float으로 자료형이 바뀜 
y = tf.keras.utils.to_categorical(y_train)
XX = x_test.reshape(-1,28,28,1)/255
yy = tf.keras.utils.to_categorical(y_test)

255로 나누면

  • type이 float이 되고
  • 0 ~ 255를 0 ~ 1로 표준화도 되고
    • 표준화가 어느정도 되어 있어야 표현력이 높아진다.
    • $255 \times 1$ 보다 $1 \times \frac{1}{255}$가 나음

CNN 말고 DNN으로 받으려고 flatten이랑~

  • 이미지니까 categorical_crossentropy 써주자
net = tf.keras.Sequential()
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(50,activation='relu'))
net.add(tf.keras.layers.Dense(10,activation='softmax'))
net.compile(optimizer='adam',loss=tf.losses.categorical_crossentropy,metrics='accuracy')
x.shape
(100, 1)

20%를 valdation으로 빼서 학습을 시킬 것이다.

  • 아래 해석: 뺀 20%의 validation을 제외한 80%으로 학습을 한다.그것으로 20%를 맞춰보니 val_accuracy가 0.8~이러고 나왔다.
  • 한 40 정도에서는 끊어져야 하지 않을까? 그 이후에는 val_accuracy가 높아지지 않으니까.
    • 우리의 목표는 val_accuracy가 높아지는 것이니까 끊는게 좋겠다.
cb1 = tf.keras.callbacks.TensorBoard()
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb1,verbose=1) 

Epoch 1/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0739 - accuracy: 0.9743 - val_loss: 0.6479 - val_accuracy: 0.8736
Epoch 2/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0694 - accuracy: 0.9769 - val_loss: 0.6491 - val_accuracy: 0.8726
Epoch 3/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0692 - accuracy: 0.9769 - val_loss: 0.6616 - val_accuracy: 0.8723
Epoch 4/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0717 - accuracy: 0.9757 - val_loss: 0.6523 - val_accuracy: 0.8742
Epoch 5/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0689 - accuracy: 0.9770 - val_loss: 0.6482 - val_accuracy: 0.8738
Epoch 6/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0698 - accuracy: 0.9768 - val_loss: 0.6497 - val_accuracy: 0.8746
Epoch 7/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0703 - accuracy: 0.9766 - val_loss: 0.6696 - val_accuracy: 0.8728
Epoch 8/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0665 - accuracy: 0.9780 - val_loss: 0.6529 - val_accuracy: 0.8753
Epoch 9/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0680 - accuracy: 0.9770 - val_loss: 0.6757 - val_accuracy: 0.8720
Epoch 10/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0667 - accuracy: 0.9775 - val_loss: 0.6730 - val_accuracy: 0.8755
Epoch 11/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0673 - accuracy: 0.9786 - val_loss: 0.6627 - val_accuracy: 0.8748
Epoch 12/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0684 - accuracy: 0.9774 - val_loss: 0.6711 - val_accuracy: 0.8753
Epoch 13/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0657 - accuracy: 0.9786 - val_loss: 0.6694 - val_accuracy: 0.8739
Epoch 14/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0676 - accuracy: 0.9777 - val_loss: 0.7010 - val_accuracy: 0.8697
Epoch 15/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0695 - accuracy: 0.9771 - val_loss: 0.6836 - val_accuracy: 0.8742
Epoch 16/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0638 - accuracy: 0.9785 - val_loss: 0.6973 - val_accuracy: 0.8737
Epoch 17/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0653 - accuracy: 0.9781 - val_loss: 0.6705 - val_accuracy: 0.8750
Epoch 18/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0703 - accuracy: 0.9758 - val_loss: 0.7052 - val_accuracy: 0.8707
Epoch 19/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0634 - accuracy: 0.9792 - val_loss: 0.6814 - val_accuracy: 0.8717
Epoch 20/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0625 - accuracy: 0.9797 - val_loss: 0.6851 - val_accuracy: 0.8743
Epoch 21/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0679 - accuracy: 0.9765 - val_loss: 0.6870 - val_accuracy: 0.8724
Epoch 22/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0630 - accuracy: 0.9785 - val_loss: 0.7130 - val_accuracy: 0.8717
Epoch 23/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0718 - accuracy: 0.9752 - val_loss: 0.6983 - val_accuracy: 0.8733
Epoch 24/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0619 - accuracy: 0.9795 - val_loss: 0.6943 - val_accuracy: 0.8766
Epoch 25/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0678 - accuracy: 0.9772 - val_loss: 0.7039 - val_accuracy: 0.8684
Epoch 26/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0628 - accuracy: 0.9792 - val_loss: 0.6918 - val_accuracy: 0.8756
Epoch 27/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0594 - accuracy: 0.9810 - val_loss: 0.6963 - val_accuracy: 0.8730
Epoch 28/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0577 - accuracy: 0.9818 - val_loss: 0.7054 - val_accuracy: 0.8753
Epoch 29/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0592 - accuracy: 0.9809 - val_loss: 0.7049 - val_accuracy: 0.8750
Epoch 30/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0619 - accuracy: 0.9793 - val_loss: 0.7107 - val_accuracy: 0.8726
Epoch 31/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0656 - accuracy: 0.9780 - val_loss: 0.7041 - val_accuracy: 0.8771
Epoch 32/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0584 - accuracy: 0.9808 - val_loss: 0.7094 - val_accuracy: 0.8737
Epoch 33/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0612 - accuracy: 0.9790 - val_loss: 0.7399 - val_accuracy: 0.8709
Epoch 34/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0569 - accuracy: 0.9814 - val_loss: 0.7130 - val_accuracy: 0.8714
Epoch 35/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0586 - accuracy: 0.9806 - val_loss: 0.7255 - val_accuracy: 0.8724
Epoch 36/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0573 - accuracy: 0.9810 - val_loss: 0.7453 - val_accuracy: 0.8727
Epoch 37/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0611 - accuracy: 0.9794 - val_loss: 0.7260 - val_accuracy: 0.8745
Epoch 38/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0641 - accuracy: 0.9784 - val_loss: 0.7384 - val_accuracy: 0.8708
Epoch 39/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0600 - accuracy: 0.9802 - val_loss: 0.7185 - val_accuracy: 0.8742
Epoch 40/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0575 - accuracy: 0.9812 - val_loss: 0.7176 - val_accuracy: 0.8758
Epoch 41/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0576 - accuracy: 0.9804 - val_loss: 0.7303 - val_accuracy: 0.8733
Epoch 42/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0601 - accuracy: 0.9800 - val_loss: 0.7311 - val_accuracy: 0.8728
Epoch 43/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0581 - accuracy: 0.9802 - val_loss: 0.7477 - val_accuracy: 0.8745
Epoch 44/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0577 - accuracy: 0.9808 - val_loss: 0.7396 - val_accuracy: 0.8749
Epoch 45/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0551 - accuracy: 0.9820 - val_loss: 0.7456 - val_accuracy: 0.8713
Epoch 46/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0588 - accuracy: 0.9799 - val_loss: 0.7560 - val_accuracy: 0.8715
Epoch 47/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0610 - accuracy: 0.9794 - val_loss: 0.7559 - val_accuracy: 0.8693
Epoch 48/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0517 - accuracy: 0.9830 - val_loss: 0.7432 - val_accuracy: 0.8731
Epoch 49/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0561 - accuracy: 0.9812 - val_loss: 0.7700 - val_accuracy: 0.8678
Epoch 50/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0541 - accuracy: 0.9824 - val_loss: 0.7421 - val_accuracy: 0.8740
Epoch 51/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0600 - accuracy: 0.9793 - val_loss: 0.7385 - val_accuracy: 0.8751
Epoch 52/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0559 - accuracy: 0.9813 - val_loss: 0.7661 - val_accuracy: 0.8714
Epoch 53/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0583 - accuracy: 0.9809 - val_loss: 0.7691 - val_accuracy: 0.8712
Epoch 54/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0533 - accuracy: 0.9820 - val_loss: 0.7666 - val_accuracy: 0.8743
Epoch 55/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0514 - accuracy: 0.9839 - val_loss: 0.7781 - val_accuracy: 0.8733
Epoch 56/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0554 - accuracy: 0.9810 - val_loss: 0.7781 - val_accuracy: 0.8716
Epoch 57/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0586 - accuracy: 0.9802 - val_loss: 0.7568 - val_accuracy: 0.8723
Epoch 58/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0501 - accuracy: 0.9838 - val_loss: 0.7716 - val_accuracy: 0.8701
Epoch 59/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0508 - accuracy: 0.9830 - val_loss: 0.7655 - val_accuracy: 0.8717
Epoch 60/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0516 - accuracy: 0.9832 - val_loss: 0.7930 - val_accuracy: 0.8708
Epoch 61/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0561 - accuracy: 0.9812 - val_loss: 0.8031 - val_accuracy: 0.8700
Epoch 62/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0513 - accuracy: 0.9834 - val_loss: 0.7844 - val_accuracy: 0.8722
Epoch 63/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0524 - accuracy: 0.9826 - val_loss: 0.7902 - val_accuracy: 0.8696
Epoch 64/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0515 - accuracy: 0.9832 - val_loss: 0.8034 - val_accuracy: 0.8683
Epoch 65/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0476 - accuracy: 0.9847 - val_loss: 0.7984 - val_accuracy: 0.8702
Epoch 66/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0530 - accuracy: 0.9816 - val_loss: 0.8005 - val_accuracy: 0.8707
Epoch 67/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0511 - accuracy: 0.9834 - val_loss: 0.7899 - val_accuracy: 0.8696
Epoch 68/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0481 - accuracy: 0.9841 - val_loss: 0.7885 - val_accuracy: 0.8724
Epoch 69/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0501 - accuracy: 0.9829 - val_loss: 0.7863 - val_accuracy: 0.8721
Epoch 70/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0538 - accuracy: 0.9818 - val_loss: 0.8078 - val_accuracy: 0.8704
Epoch 71/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0540 - accuracy: 0.9810 - val_loss: 0.8011 - val_accuracy: 0.8684
Epoch 72/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0485 - accuracy: 0.9840 - val_loss: 0.7795 - val_accuracy: 0.8727
Epoch 73/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0494 - accuracy: 0.9834 - val_loss: 0.7984 - val_accuracy: 0.8745
Epoch 74/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0491 - accuracy: 0.9834 - val_loss: 0.7996 - val_accuracy: 0.8692
Epoch 75/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0511 - accuracy: 0.9830 - val_loss: 0.8042 - val_accuracy: 0.8709
Epoch 76/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0455 - accuracy: 0.9846 - val_loss: 0.8006 - val_accuracy: 0.8702
Epoch 77/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0504 - accuracy: 0.9831 - val_loss: 0.8045 - val_accuracy: 0.8692
Epoch 78/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0476 - accuracy: 0.9847 - val_loss: 0.8408 - val_accuracy: 0.8702
Epoch 79/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0504 - accuracy: 0.9840 - val_loss: 0.8045 - val_accuracy: 0.8681
Epoch 80/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0439 - accuracy: 0.9864 - val_loss: 0.8024 - val_accuracy: 0.8714
Epoch 81/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0463 - accuracy: 0.9848 - val_loss: 0.8147 - val_accuracy: 0.8698
Epoch 82/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0479 - accuracy: 0.9835 - val_loss: 0.8159 - val_accuracy: 0.8733
Epoch 83/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0469 - accuracy: 0.9843 - val_loss: 0.8203 - val_accuracy: 0.8714
Epoch 84/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0437 - accuracy: 0.9859 - val_loss: 0.8294 - val_accuracy: 0.8703
Epoch 85/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0485 - accuracy: 0.9836 - val_loss: 0.8578 - val_accuracy: 0.8677
Epoch 86/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0548 - accuracy: 0.9812 - val_loss: 0.8744 - val_accuracy: 0.8692
Epoch 87/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0428 - accuracy: 0.9870 - val_loss: 0.8249 - val_accuracy: 0.8727
Epoch 88/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0412 - accuracy: 0.9869 - val_loss: 0.8358 - val_accuracy: 0.8700
Epoch 89/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0501 - accuracy: 0.9822 - val_loss: 0.8284 - val_accuracy: 0.8723
Epoch 90/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0473 - accuracy: 0.9840 - val_loss: 0.8239 - val_accuracy: 0.8742
Epoch 91/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0446 - accuracy: 0.9855 - val_loss: 0.8341 - val_accuracy: 0.8702
Epoch 92/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0457 - accuracy: 0.9849 - val_loss: 0.8384 - val_accuracy: 0.8689
Epoch 93/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0452 - accuracy: 0.9847 - val_loss: 0.8330 - val_accuracy: 0.8747
Epoch 94/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0435 - accuracy: 0.9853 - val_loss: 0.8714 - val_accuracy: 0.8698
Epoch 95/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0428 - accuracy: 0.9860 - val_loss: 0.8581 - val_accuracy: 0.8686
Epoch 96/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0507 - accuracy: 0.9824 - val_loss: 0.8590 - val_accuracy: 0.8705
Epoch 97/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0413 - accuracy: 0.9861 - val_loss: 0.8483 - val_accuracy: 0.8703
Epoch 98/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0405 - accuracy: 0.9877 - val_loss: 0.8398 - val_accuracy: 0.8710
Epoch 99/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0407 - accuracy: 0.9872 - val_loss: 0.8464 - val_accuracy: 0.8703
Epoch 100/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0515 - accuracy: 0.9822 - val_loss: 0.8569 - val_accuracy: 0.8728
Epoch 101/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0413 - accuracy: 0.9870 - val_loss: 0.8622 - val_accuracy: 0.8685
Epoch 102/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0473 - accuracy: 0.9840 - val_loss: 0.8942 - val_accuracy: 0.8687
Epoch 103/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0493 - accuracy: 0.9839 - val_loss: 0.8599 - val_accuracy: 0.8717
Epoch 104/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0413 - accuracy: 0.9866 - val_loss: 0.8609 - val_accuracy: 0.8713
Epoch 105/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0409 - accuracy: 0.9864 - val_loss: 0.8830 - val_accuracy: 0.8699
Epoch 106/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0369 - accuracy: 0.9885 - val_loss: 0.8817 - val_accuracy: 0.8717
Epoch 107/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0432 - accuracy: 0.9852 - val_loss: 0.8812 - val_accuracy: 0.8675
Epoch 108/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0391 - accuracy: 0.9872 - val_loss: 0.8680 - val_accuracy: 0.8683
Epoch 109/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0406 - accuracy: 0.9868 - val_loss: 0.8937 - val_accuracy: 0.8645
Epoch 110/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0411 - accuracy: 0.9862 - val_loss: 0.8966 - val_accuracy: 0.8662
Epoch 111/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0492 - accuracy: 0.9832 - val_loss: 0.8811 - val_accuracy: 0.8742
Epoch 112/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0388 - accuracy: 0.9872 - val_loss: 0.8765 - val_accuracy: 0.8694
Epoch 113/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0451 - accuracy: 0.9848 - val_loss: 0.9364 - val_accuracy: 0.8708
Epoch 114/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0377 - accuracy: 0.9879 - val_loss: 0.8792 - val_accuracy: 0.8717
Epoch 115/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0387 - accuracy: 0.9877 - val_loss: 0.8825 - val_accuracy: 0.8697
Epoch 116/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0422 - accuracy: 0.9855 - val_loss: 0.8797 - val_accuracy: 0.8732
Epoch 117/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0384 - accuracy: 0.9878 - val_loss: 0.9020 - val_accuracy: 0.8708
Epoch 118/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0461 - accuracy: 0.9835 - val_loss: 0.9062 - val_accuracy: 0.8710
Epoch 119/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0373 - accuracy: 0.9885 - val_loss: 0.9100 - val_accuracy: 0.8683
Epoch 120/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0418 - accuracy: 0.9855 - val_loss: 0.8770 - val_accuracy: 0.8715
Epoch 121/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0420 - accuracy: 0.9857 - val_loss: 0.9350 - val_accuracy: 0.8680
Epoch 122/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0418 - accuracy: 0.9864 - val_loss: 0.9297 - val_accuracy: 0.8658
Epoch 123/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0382 - accuracy: 0.9874 - val_loss: 0.8977 - val_accuracy: 0.8729
Epoch 124/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0420 - accuracy: 0.9864 - val_loss: 0.9124 - val_accuracy: 0.8716
Epoch 125/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0354 - accuracy: 0.9887 - val_loss: 0.9085 - val_accuracy: 0.8688
Epoch 126/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0403 - accuracy: 0.9865 - val_loss: 0.9202 - val_accuracy: 0.8703
Epoch 127/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0400 - accuracy: 0.9869 - val_loss: 0.9095 - val_accuracy: 0.8708
Epoch 128/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0368 - accuracy: 0.9880 - val_loss: 0.9127 - val_accuracy: 0.8705
Epoch 129/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0412 - accuracy: 0.9871 - val_loss: 0.9065 - val_accuracy: 0.8713
Epoch 130/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0333 - accuracy: 0.9891 - val_loss: 0.9083 - val_accuracy: 0.8712
Epoch 131/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0372 - accuracy: 0.9878 - val_loss: 0.9444 - val_accuracy: 0.8638
Epoch 132/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0418 - accuracy: 0.9862 - val_loss: 0.9335 - val_accuracy: 0.8691
Epoch 133/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0418 - accuracy: 0.9861 - val_loss: 0.9234 - val_accuracy: 0.8698
Epoch 134/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0333 - accuracy: 0.9891 - val_loss: 0.9453 - val_accuracy: 0.8671
Epoch 135/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0337 - accuracy: 0.9889 - val_loss: 0.9316 - val_accuracy: 0.8709
Epoch 136/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0351 - accuracy: 0.9882 - val_loss: 0.9238 - val_accuracy: 0.8704
Epoch 137/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0339 - accuracy: 0.9887 - val_loss: 0.9206 - val_accuracy: 0.8712
Epoch 138/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0368 - accuracy: 0.9877 - val_loss: 0.9531 - val_accuracy: 0.8687
Epoch 139/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0321 - accuracy: 0.9904 - val_loss: 0.9311 - val_accuracy: 0.8711
Epoch 140/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0414 - accuracy: 0.9862 - val_loss: 0.9664 - val_accuracy: 0.8684
Epoch 141/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0370 - accuracy: 0.9873 - val_loss: 0.9412 - val_accuracy: 0.8698
Epoch 142/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0332 - accuracy: 0.9897 - val_loss: 0.9607 - val_accuracy: 0.8675
Epoch 143/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0353 - accuracy: 0.9883 - val_loss: 0.9616 - val_accuracy: 0.8663
Epoch 144/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0347 - accuracy: 0.9886 - val_loss: 0.9633 - val_accuracy: 0.8692
Epoch 145/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0335 - accuracy: 0.9898 - val_loss: 0.9780 - val_accuracy: 0.8673
Epoch 146/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0336 - accuracy: 0.9895 - val_loss: 0.9465 - val_accuracy: 0.8708
Epoch 147/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0401 - accuracy: 0.9869 - val_loss: 0.9635 - val_accuracy: 0.8697
Epoch 148/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0361 - accuracy: 0.9881 - val_loss: 0.9839 - val_accuracy: 0.8679
Epoch 149/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0412 - accuracy: 0.9860 - val_loss: 0.9606 - val_accuracy: 0.8725
Epoch 150/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0312 - accuracy: 0.9904 - val_loss: 0.9511 - val_accuracy: 0.8709
Epoch 151/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0317 - accuracy: 0.9897 - val_loss: 0.9668 - val_accuracy: 0.8712
Epoch 152/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0338 - accuracy: 0.9895 - val_loss: 0.9609 - val_accuracy: 0.8711
Epoch 153/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0383 - accuracy: 0.9872 - val_loss: 0.9816 - val_accuracy: 0.8692
Epoch 154/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0301 - accuracy: 0.9911 - val_loss: 0.9526 - val_accuracy: 0.8686
Epoch 155/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0323 - accuracy: 0.9892 - val_loss: 0.9598 - val_accuracy: 0.8683
Epoch 156/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0317 - accuracy: 0.9897 - val_loss: 0.9968 - val_accuracy: 0.8676
Epoch 157/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0303 - accuracy: 0.9906 - val_loss: 0.9830 - val_accuracy: 0.8682
Epoch 158/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0410 - accuracy: 0.9860 - val_loss: 1.0750 - val_accuracy: 0.8634
Epoch 159/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0384 - accuracy: 0.9878 - val_loss: 1.0036 - val_accuracy: 0.8661
Epoch 160/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0346 - accuracy: 0.9886 - val_loss: 0.9764 - val_accuracy: 0.8706
Epoch 161/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0330 - accuracy: 0.9891 - val_loss: 0.9940 - val_accuracy: 0.8723
Epoch 162/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0281 - accuracy: 0.9918 - val_loss: 0.9813 - val_accuracy: 0.8719
Epoch 163/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0283 - accuracy: 0.9911 - val_loss: 1.0107 - val_accuracy: 0.8686
Epoch 164/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0392 - accuracy: 0.9866 - val_loss: 0.9868 - val_accuracy: 0.8695
Epoch 165/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0284 - accuracy: 0.9914 - val_loss: 0.9845 - val_accuracy: 0.8702
Epoch 166/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0308 - accuracy: 0.9898 - val_loss: 1.0053 - val_accuracy: 0.8699
Epoch 167/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0295 - accuracy: 0.9903 - val_loss: 0.9996 - val_accuracy: 0.8698
Epoch 168/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0309 - accuracy: 0.9897 - val_loss: 1.0013 - val_accuracy: 0.8693
Epoch 169/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0348 - accuracy: 0.9886 - val_loss: 1.0201 - val_accuracy: 0.8699
Epoch 170/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0336 - accuracy: 0.9891 - val_loss: 1.0624 - val_accuracy: 0.8623
Epoch 171/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0400 - accuracy: 0.9856 - val_loss: 1.0075 - val_accuracy: 0.8714
Epoch 172/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0283 - accuracy: 0.9911 - val_loss: 1.0117 - val_accuracy: 0.8694
Epoch 173/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0321 - accuracy: 0.9890 - val_loss: 0.9917 - val_accuracy: 0.8706
Epoch 174/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0273 - accuracy: 0.9911 - val_loss: 1.0176 - val_accuracy: 0.8684
Epoch 175/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0375 - accuracy: 0.9875 - val_loss: 1.0277 - val_accuracy: 0.8682
Epoch 176/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0274 - accuracy: 0.9912 - val_loss: 1.0145 - val_accuracy: 0.8714
Epoch 177/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0300 - accuracy: 0.9906 - val_loss: 1.0152 - val_accuracy: 0.8686
Epoch 178/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0247 - accuracy: 0.9926 - val_loss: 1.0244 - val_accuracy: 0.8700
Epoch 179/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0290 - accuracy: 0.9908 - val_loss: 1.0125 - val_accuracy: 0.8719
Epoch 180/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0280 - accuracy: 0.9912 - val_loss: 1.0212 - val_accuracy: 0.8699
Epoch 181/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0306 - accuracy: 0.9900 - val_loss: 1.0240 - val_accuracy: 0.8652
Epoch 182/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0309 - accuracy: 0.9902 - val_loss: 1.0208 - val_accuracy: 0.8716
Epoch 183/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0334 - accuracy: 0.9889 - val_loss: 1.0276 - val_accuracy: 0.8687
Epoch 184/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0292 - accuracy: 0.9901 - val_loss: 1.0357 - val_accuracy: 0.8684
Epoch 185/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0298 - accuracy: 0.9904 - val_loss: 1.0384 - val_accuracy: 0.8696
Epoch 186/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0286 - accuracy: 0.9909 - val_loss: 1.0388 - val_accuracy: 0.8671
Epoch 187/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0292 - accuracy: 0.9903 - val_loss: 1.0247 - val_accuracy: 0.8682
Epoch 188/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0300 - accuracy: 0.9904 - val_loss: 1.0421 - val_accuracy: 0.8683
Epoch 189/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0384 - accuracy: 0.9864 - val_loss: 1.0659 - val_accuracy: 0.8677
Epoch 190/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0277 - accuracy: 0.9911 - val_loss: 1.0429 - val_accuracy: 0.8712
Epoch 191/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0296 - accuracy: 0.9907 - val_loss: 1.0657 - val_accuracy: 0.8702
Epoch 192/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0295 - accuracy: 0.9902 - val_loss: 1.0342 - val_accuracy: 0.8695
Epoch 193/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0216 - accuracy: 0.9936 - val_loss: 1.0715 - val_accuracy: 0.8693
Epoch 194/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0304 - accuracy: 0.9900 - val_loss: 1.0507 - val_accuracy: 0.8662
Epoch 195/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0319 - accuracy: 0.9894 - val_loss: 1.0426 - val_accuracy: 0.8732
Epoch 196/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0286 - accuracy: 0.9905 - val_loss: 1.0477 - val_accuracy: 0.8704
Epoch 197/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0289 - accuracy: 0.9908 - val_loss: 1.0816 - val_accuracy: 0.8705
Epoch 198/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0377 - accuracy: 0.9872 - val_loss: 1.0396 - val_accuracy: 0.8680
Epoch 199/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0234 - accuracy: 0.9930 - val_loss: 1.0712 - val_accuracy: 0.8654
Epoch 200/200
240/240 [==============================] - 1s 4ms/step - loss: 0.0256 - accuracy: 0.9919 - val_loss: 1.0607 - val_accuracy: 0.8704
<keras.callbacks.History at 0x7fdaf86957e0>

callback 넣었을 때랑 넣지 않았을때랑 시작하는 accuracy가 달랐다.

이미지니까 loss function tf.losses.categorical_crossentropy

,validation_split=0.2 20%만큼 validattion 을 val set 으로 뺴내겠다.

한 20 전에는 끊어도 상관없어, 그 이후에는 accuracy 변화가 거의 없다고 해도 무방하니까!

- 텐서보드 여는 방법1

%load_ext tensorboard
# 주피터노트북 (혹은 주피터랩)에서 텐서보드를 임베딩하여 넣을 수 있도록 도와주는 매직펑션
#!kill 313799

주피터랩의 서버로 늘어가는 경우는 IP주소같은 형식의 무엇인가가 필요한가봐

training accuracy는 올라가는데 validation accuracy는 그저 그렇다(우리의 목적이 아님)

training loss는 줄어들고 있는데 validation loss는 오히려 커지고 있다.(이상함을 감지)

-> 오버피팅의 징조!!!

%tensorboard --logdir logs --host 0.0.0.0
# %tensorboard --logdir logs <-- 실습에서는 이렇게 하면됩니다. 

(참고사항) 파이썬 3.10의 경우 아래의 수정이 필요

?/python3.10/site-packages/tensorboard/_vendor/html5lib/_trie/_base.py 을 열고

from collections import Mapping ### 수정전
from collections.abc import Mapping ### 수정후

와 같이 수정한다.

  • 왜냐하면 파이썬 3.10부터 from collections import Mapping 가 동작하지 않고 from collections.abc import Mapping 가 동작하도록 문법이 바뀜

- 텐서보드를 실행하는 방법2

!tensorboard --logdir logs --host 0.0.0.0
#!tensorboard --logdir logs
#<-- 실습에서는 이렇게 하면됩니다. 
NOTE: Using experimental fast data loading logic. To disable, pass
    "--load_fast=false" and report issues on GitHub. More details:
    https://github.com/tensorflow/tensorboard/issues/4784

TensorBoard 2.6.0 at http://0.0.0.0:6007/ (Press CTRL+C to quit)
^C

조기종료

- 텐서보드를 살펴보니 특정에폭 이후에는 오히려 과적합이 진행되는 듯 하다 (학습할수록 손해인듯 하다) $\to$ 그 특정에폭까지만 학습해보자

tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(5000,activation='relu')) ## 과적합좀 시키려고 
net.add(tf.keras.layers.Dense(5000,activation='relu')) ## 레이어를 2장만듦 + 레이어하나당 노드수도 증가 
net.add(tf.keras.layers.Dense(10,activation='softmax'))
net.compile(optimizer='adam',loss=tf.losses.categorical_crossentropy,metrics='accuracy')

val-loss 가 한 번 올라간다? 즉, 그래프가 상승해서 멈춘다! 는 뜻! 오목한 부분이 끝날때마다!

#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=1) # val-loss가 1회 증가하면 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 2s 6ms/step - loss: 0.5493 - accuracy: 0.8127 - val_loss: 0.4113 - val_accuracy: 0.8497
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.3571 - accuracy: 0.8673 - val_loss: 0.3793 - val_accuracy: 0.8649
Epoch 3/200
240/240 [==============================] - 1s 6ms/step - loss: 0.3254 - accuracy: 0.8791 - val_loss: 0.3679 - val_accuracy: 0.8677
Epoch 4/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2978 - accuracy: 0.8869 - val_loss: 0.3498 - val_accuracy: 0.8791
Epoch 5/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2794 - accuracy: 0.8960 - val_loss: 0.3341 - val_accuracy: 0.8791
Epoch 6/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2618 - accuracy: 0.9001 - val_loss: 0.3264 - val_accuracy: 0.8827
Epoch 7/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2472 - accuracy: 0.9066 - val_loss: 0.3363 - val_accuracy: 0.8802
<keras.callbacks.History at 0x7f54031d1540>
#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=1) # val-loss가 1회증가하면 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2388 - accuracy: 0.9080 - val_loss: 0.3112 - val_accuracy: 0.8863
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2245 - accuracy: 0.9143 - val_loss: 0.3266 - val_accuracy: 0.8887
<keras.callbacks.History at 0x7f5403070fd0>
#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=1) # val-loss가 1회증가하면 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2164 - accuracy: 0.9161 - val_loss: 0.3316 - val_accuracy: 0.8876
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2010 - accuracy: 0.9223 - val_loss: 0.3334 - val_accuracy: 0.8884
<keras.callbacks.History at 0x7f54030de320>
#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=1) # val-loss가 1회증가하면 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1909 - accuracy: 0.9257 - val_loss: 0.3789 - val_accuracy: 0.8819
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1864 - accuracy: 0.9275 - val_loss: 0.3458 - val_accuracy: 0.8890
Epoch 3/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1852 - accuracy: 0.9290 - val_loss: 0.3508 - val_accuracy: 0.8903
<keras.callbacks.History at 0x7f5403116d10>
#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=1) # val-loss가 1회증가하면 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 2s 6ms/step - loss: 0.1653 - accuracy: 0.9339 - val_loss: 0.3870 - val_accuracy: 0.8848
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1574 - accuracy: 0.9383 - val_loss: 0.3708 - val_accuracy: 0.8921
Epoch 3/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1558 - accuracy: 0.9390 - val_loss: 0.3727 - val_accuracy: 0.8890
<keras.callbacks.History at 0x7f5403147bb0>

- 몇 번 좀 참았다가 멈추면 좋겠다.

tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(5000,activation='relu')) ## 과적합좀 시키려고 
net.add(tf.keras.layers.Dense(5000,activation='relu')) ## 레이어를 2장만듬 + 레이어하나당 노드수도 증가 
net.add(tf.keras.layers.Dense(10,activation='softmax'))
net.compile(optimizer='adam',loss=tf.losses.categorical_crossentropy,metrics='accuracy')
#cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=5) # 좀더 참다가 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=cb2,verbose=1) 
Epoch 1/200
240/240 [==============================] - 2s 6ms/step - loss: 0.5489 - accuracy: 0.8131 - val_loss: 0.4094 - val_accuracy: 0.8514
Epoch 2/200
240/240 [==============================] - 1s 6ms/step - loss: 0.3556 - accuracy: 0.8681 - val_loss: 0.3624 - val_accuracy: 0.8708
Epoch 3/200
240/240 [==============================] - 1s 6ms/step - loss: 0.3206 - accuracy: 0.8796 - val_loss: 0.3538 - val_accuracy: 0.8715
Epoch 4/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2952 - accuracy: 0.8889 - val_loss: 0.3466 - val_accuracy: 0.8776
Epoch 5/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2775 - accuracy: 0.8963 - val_loss: 0.3236 - val_accuracy: 0.8822
Epoch 6/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2600 - accuracy: 0.9015 - val_loss: 0.3257 - val_accuracy: 0.8818
Epoch 7/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2449 - accuracy: 0.9080 - val_loss: 0.3098 - val_accuracy: 0.8875
Epoch 8/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2315 - accuracy: 0.9110 - val_loss: 0.3289 - val_accuracy: 0.8860
Epoch 9/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2230 - accuracy: 0.9161 - val_loss: 0.3139 - val_accuracy: 0.8903
Epoch 10/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2101 - accuracy: 0.9188 - val_loss: 0.3216 - val_accuracy: 0.8887
Epoch 11/200
240/240 [==============================] - 1s 6ms/step - loss: 0.2087 - accuracy: 0.9197 - val_loss: 0.3342 - val_accuracy: 0.8827
Epoch 12/200
240/240 [==============================] - 1s 6ms/step - loss: 0.1988 - accuracy: 0.9235 - val_loss: 0.3245 - val_accuracy: 0.8942
<keras.callbacks.History at 0x7f51fc5e1d50>

- 텐서보드로 그려보자?

텐서보드 기능이 없는 상태

%tensorboard --logdir logs --host 0.0.0.0 
# 아무것도 안나온다 -> 왜? cb1을 써야 텐서보드가 나옴

조기종료cb2와 텐서플로우show cb1을 함께 써서 안 보이는 문제가 생겨버렸다.

- 조기종료와 텐서보드를 같이 쓰려면?

 
tf.random.set_seed(43052)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(50,activation='relu')) 
net.add(tf.keras.layers.Dense(10,activation='softmax'))
net.compile(optimizer='adam',loss=tf.losses.categorical_crossentropy,metrics='accuracy')
cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=7) # 좀더 참다가 멈추어라 
net.fit(X,y,epochs=200,batch_size=200,validation_split=0.2,callbacks=[cb1,cb2]) 
Epoch 1/200
240/240 [==============================] - 1s 5ms/step - loss: 0.7184 - accuracy: 0.7581 - val_loss: 0.5077 - val_accuracy: 0.8276
Epoch 2/200
240/240 [==============================] - 1s 4ms/step - loss: 0.4752 - accuracy: 0.8386 - val_loss: 0.4793 - val_accuracy: 0.8342
Epoch 3/200
240/240 [==============================] - 1s 4ms/step - loss: 0.4304 - accuracy: 0.8517 - val_loss: 0.4386 - val_accuracy: 0.8497
Epoch 4/200
240/240 [==============================] - 1s 4ms/step - loss: 0.4048 - accuracy: 0.8582 - val_loss: 0.4029 - val_accuracy: 0.8603
Epoch 5/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3832 - accuracy: 0.8669 - val_loss: 0.3932 - val_accuracy: 0.8619
Epoch 6/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3697 - accuracy: 0.8705 - val_loss: 0.3842 - val_accuracy: 0.8657
Epoch 7/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3569 - accuracy: 0.8759 - val_loss: 0.3844 - val_accuracy: 0.8668
Epoch 8/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3482 - accuracy: 0.8774 - val_loss: 0.3679 - val_accuracy: 0.8708
Epoch 9/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3387 - accuracy: 0.8799 - val_loss: 0.3602 - val_accuracy: 0.8719
Epoch 10/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3299 - accuracy: 0.8820 - val_loss: 0.3610 - val_accuracy: 0.8748
Epoch 11/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3229 - accuracy: 0.8858 - val_loss: 0.3574 - val_accuracy: 0.8717
Epoch 12/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3157 - accuracy: 0.8873 - val_loss: 0.3572 - val_accuracy: 0.8743
Epoch 13/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3106 - accuracy: 0.8899 - val_loss: 0.3545 - val_accuracy: 0.8761
Epoch 14/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3046 - accuracy: 0.8914 - val_loss: 0.3493 - val_accuracy: 0.8759
Epoch 15/200
240/240 [==============================] - 1s 4ms/step - loss: 0.3011 - accuracy: 0.8928 - val_loss: 0.3483 - val_accuracy: 0.8776
Epoch 16/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2988 - accuracy: 0.8935 - val_loss: 0.3733 - val_accuracy: 0.8716
Epoch 17/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2925 - accuracy: 0.8947 - val_loss: 0.3481 - val_accuracy: 0.8768
Epoch 18/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2880 - accuracy: 0.8951 - val_loss: 0.3396 - val_accuracy: 0.8801
Epoch 19/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2827 - accuracy: 0.8982 - val_loss: 0.3439 - val_accuracy: 0.8798
Epoch 20/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2791 - accuracy: 0.8986 - val_loss: 0.3489 - val_accuracy: 0.8779
Epoch 21/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2765 - accuracy: 0.9007 - val_loss: 0.3350 - val_accuracy: 0.8823
Epoch 22/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2709 - accuracy: 0.9016 - val_loss: 0.3350 - val_accuracy: 0.8812
Epoch 23/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2688 - accuracy: 0.9029 - val_loss: 0.3374 - val_accuracy: 0.8820
Epoch 24/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2658 - accuracy: 0.9041 - val_loss: 0.3445 - val_accuracy: 0.8805
Epoch 25/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2607 - accuracy: 0.9058 - val_loss: 0.3383 - val_accuracy: 0.8822
Epoch 26/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2607 - accuracy: 0.9056 - val_loss: 0.3415 - val_accuracy: 0.8811
Epoch 27/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2576 - accuracy: 0.9068 - val_loss: 0.3402 - val_accuracy: 0.8814
Epoch 28/200
240/240 [==============================] - 1s 4ms/step - loss: 0.2525 - accuracy: 0.9098 - val_loss: 0.3469 - val_accuracy: 0.8802
<keras.callbacks.History at 0x7f51fc47c0a0>

결과 해석

  • training accuracy가 validation accuracy보다 높다?
  • training loss가 validation loss보다 낮다?
# 조기종료가 구현된 그림이 출력
%tensorboard --logdir logs --host 0.0.0.0 
Reusing TensorBoard on port 6006 (pid 702426), started 0:01:48 ago. (Use '!kill 702426' to kill it.)

하이퍼파라메터 선택

- 하이퍼파라메터 설정

여러 상황에서 반복 실험시 유용

from tensorboard.plugins.hparams import api as hp
a=net.evaluate(XX,yy)
313/313 [==============================] - 1s 3ms/step - loss: 0.3817 - accuracy: 0.8706
type(a)
list
a
[0.3817201852798462, 0.8705999851226807]

_rslt=net.evaluate(XX,yy)

  • test의 해당되는 evaluate

_mymetric=_rslt[1]*0.8 + _rslt[2]*0.2

  • 내가 보고 싶은 것은 recall
  • test의 accuracy 가 rsit[1]에 있어
  • test의 recall이 rsit[2]
  • 가중 평균을 보겠다, 이건 정해진거는 아니고 마음대로..

with문이 있다는 건 들어갈때 나갈때가 정의되어 있다는 거

!rm -rf logs
for u in [50,5000]: 
    for d in [0.0,0.5]: 
        for o in ['adam','sgd']:
            logdir = 'logs/hpguebin_{}_{}_{}'.format(u,d,o)
            with tf.summary.create_file_writer(logdir).as_default():
                net = tf.keras.Sequential()
                net.add(tf.keras.layers.Flatten())
                net.add(tf.keras.layers.Dense(u,activation='relu'))
                net.add(tf.keras.layers.Dropout(d))
                net.add(tf.keras.layers.Dense(10,activation='softmax'))
                net.compile(optimizer=o,loss=tf.losses.categorical_crossentropy,metrics=['accuracy','Recall'])
                cb3 = hp.KerasCallback(logdir, {'유닛수':u, '드랍아웃비율':d, '옵티마이저':o})
                net.fit(X,y,epochs=3,callbacks=cb3)
                _rslt=net.evaluate(XX,yy)
                _mymetric=_rslt[1]*0.8 + _rslt[2]*0.2  
                tf.summary.scalar('애큐러시와리컬의가중평균(테스트셋)', _mymetric, step=1) 
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5364 - accuracy: 0.8143 - recall: 0.7509
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4072 - accuracy: 0.8559 - recall: 0.8242
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.3725 - accuracy: 0.8668 - recall: 0.8413
313/313 [==============================] - 1s 4ms/step - loss: 0.4010 - accuracy: 0.8572 - recall: 0.8301
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.7590 - accuracy: 0.7494 - recall: 0.5859
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5225 - accuracy: 0.8223 - recall: 0.7521
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4754 - accuracy: 0.8356 - recall: 0.7833
313/313 [==============================] - 1s 3ms/step - loss: 0.4910 - accuracy: 0.8274 - recall: 0.7813
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.7480 - accuracy: 0.7374 - recall: 0.6156
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5666 - accuracy: 0.7983 - recall: 0.7225
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5325 - accuracy: 0.8080 - recall: 0.7416
313/313 [==============================] - 1s 4ms/step - loss: 0.4301 - accuracy: 0.8487 - recall: 0.7878
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 1.0498 - accuracy: 0.6383 - recall: 0.4178
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.7483 - accuracy: 0.7434 - recall: 0.6015
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.6737 - accuracy: 0.7699 - recall: 0.6519
313/313 [==============================] - 1s 4ms/step - loss: 0.5269 - accuracy: 0.8169 - recall: 0.7380
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4760 - accuracy: 0.8278 - recall: 0.7880
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.3607 - accuracy: 0.8683 - recall: 0.8424
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.3239 - accuracy: 0.8817 - recall: 0.8591
313/313 [==============================] - 1s 4ms/step - loss: 0.3508 - accuracy: 0.8737 - recall: 0.8516
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.6701 - accuracy: 0.7875 - recall: 0.6453
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4827 - accuracy: 0.8362 - recall: 0.7766
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4422 - accuracy: 0.8481 - recall: 0.8006
313/313 [==============================] - 1s 4ms/step - loss: 0.4625 - accuracy: 0.8398 - recall: 0.7971
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5722 - accuracy: 0.7997 - recall: 0.7570
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4404 - accuracy: 0.8398 - recall: 0.8067
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4103 - accuracy: 0.8504 - recall: 0.8204
313/313 [==============================] - 1s 4ms/step - loss: 0.3789 - accuracy: 0.8662 - recall: 0.8362
Epoch 1/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.6961 - accuracy: 0.7745 - recall: 0.6357
Epoch 2/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.5041 - accuracy: 0.8285 - recall: 0.7665
Epoch 3/3
1875/1875 [==============================] - 8s 4ms/step - loss: 0.4606 - accuracy: 0.8415 - recall: 0.7904
313/313 [==============================] - 1s 4ms/step - loss: 0.4603 - accuracy: 0.8402 - recall: 0.7931

opt가 adma일 때보다 sgd 일때

%tensorboard --logdir logs --host 0.0.0.0
Reusing TensorBoard on port 6006 (pid 704607), started 0:02:40 ago. (Use '!kill 704607' to kill it.)

숙제

(x_train, y_train), (x_test, y_test) = tf.keras.datasets.fashion_mnist.load_data()
X= x_train.reshape(-1,28,28,1)/255 ## 입력이 0~255 -> 0~1로 표준화 시키는 효과 + float으로 자료형이 바뀜 
y = tf.keras.utils.to_categorical(y_train)
XX = x_test.reshape(-1,28,28,1)/255
yy = tf.keras.utils.to_categorical(y_test)

- 아래의 네트워크에서 옵티마이저를 adam, sgd를 선택하여 각각 적합시켜보고 testset의 loss를 성능비교를 하라. epoch은 5정도로 설정하라.

net = tf.keras.Sequential()
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(50,activation='relu'))
net.add(tf.keras.layers.Dense(10,activation='softmax'))
net.compile(optimizer=???,loss=tf.losses.categorical_crossentropy,metrics=['accuracy','Recall'])

- adam 적합

!rm -rf logs
tf.random.set_seed(202150754)
net1 = tf.keras.Sequential()
net1.add(tf.keras.layers.Flatten())
net1.add(tf.keras.layers.Dense(50,activation='relu'))
net1.add(tf.keras.layers.Dense(10,activation='softmax'))
net1.compile(optimizer='adam',loss=tf.losses.categorical_crossentropy,metrics=['accuracy','Recall'])
cb1 = tf.keras.callbacks.TensorBoard()
cb2 = tf.keras.callbacks.EarlyStopping(patience=7) 
net1.fit(X,y,epochs=5,batch_size=200,validation_split=0.2,callbacks=[cb1,cb2]) 
Epoch 1/5
240/240 [==============================] - 2s 6ms/step - loss: 0.7224 - accuracy: 0.7586 - recall: 0.6304 - val_loss: 0.4817 - val_accuracy: 0.8329 - val_recall: 0.7788
Epoch 2/5
240/240 [==============================] - 1s 5ms/step - loss: 0.4508 - accuracy: 0.8419 - recall: 0.7951 - val_loss: 0.4497 - val_accuracy: 0.8349 - val_recall: 0.7932
Epoch 3/5
240/240 [==============================] - 1s 5ms/step - loss: 0.4064 - accuracy: 0.8567 - recall: 0.8202 - val_loss: 0.4013 - val_accuracy: 0.8540 - val_recall: 0.8188
Epoch 4/5
240/240 [==============================] - 1s 5ms/step - loss: 0.3728 - accuracy: 0.8685 - recall: 0.8364 - val_loss: 0.3892 - val_accuracy: 0.8611 - val_recall: 0.8289
Epoch 5/5
240/240 [==============================] - 1s 5ms/step - loss: 0.3571 - accuracy: 0.8714 - recall: 0.8434 - val_loss: 0.3857 - val_accuracy: 0.8620 - val_recall: 0.8403
<keras.callbacks.History at 0x7f3848153fd0>

- adam tensorboard

%tensorboard --logdir logs --host 0.0.0.0
Reusing TensorBoard on port 6006 (pid 1366833), started 0:01:06 ago. (Use '!kill 1366833' to kill it.)

- sgd 적합

!rm -rf logs
tf.random.set_seed(202150754)
net2 = tf.keras.Sequential()
net2.add(tf.keras.layers.Flatten())
net2.add(tf.keras.layers.Dense(50,activation='relu'))
net2.add(tf.keras.layers.Dense(10,activation='softmax'))
net2.compile(optimizer='sgd',loss=tf.losses.categorical_crossentropy,metrics=['accuracy','Recall'])
net2.fit(X,y,epochs=5,batch_size=200,validation_split=0.2,callbacks=[cb1,cb2]) 
Epoch 1/5
240/240 [==============================] - 2s 5ms/step - loss: 1.6588 - accuracy: 0.4999 - recall: 0.0831 - val_loss: 1.1223 - val_accuracy: 0.6730 - val_recall: 0.2842
Epoch 2/5
240/240 [==============================] - 1s 5ms/step - loss: 0.9301 - accuracy: 0.6911 - recall: 0.4377 - val_loss: 0.8035 - val_accuracy: 0.7196 - val_recall: 0.5241
Epoch 3/5
240/240 [==============================] - 1s 5ms/step - loss: 0.7534 - accuracy: 0.7372 - recall: 0.5661 - val_loss: 0.7023 - val_accuracy: 0.7613 - val_recall: 0.6117
Epoch 4/5
240/240 [==============================] - 1s 5ms/step - loss: 0.6757 - accuracy: 0.7693 - recall: 0.6336 - val_loss: 0.6443 - val_accuracy: 0.7802 - val_recall: 0.6617
Epoch 5/5
240/240 [==============================] - 1s 5ms/step - loss: 0.6253 - accuracy: 0.7891 - recall: 0.6790 - val_loss: 0.6030 - val_accuracy: 0.7968 - val_recall: 0.6976
<keras.callbacks.History at 0x7f8ca85c3370>

- sgd tensorboard

%tensorboard --logdir logs --host 0.0.0.0
Reusing TensorBoard on port 6006 (pid 847006), started 0:00:02 ago. (Use '!kill 847006' to kill it.)
net1.evaluate(XX,yy)[0]
313/313 [==============================] - 1s 4ms/step - loss: 0.4171 - accuracy: 0.8543 - recall: 0.8275
0.41707098484039307
net2.evaluate(XX,yy)[0]
313/313 [==============================] - 1s 4ms/step - loss: 0.6277 - accuracy: 0.7835 - recall: 0.6898
0.6277241706848145

adam을 optimizer로 선택하였을때 loss는 0.41707104444503784이었으며,

sgd를 optimizer로 선택하였을때 loss는 0.6277242302894592이었다.

loss값만 보았을때는 adam이 sgd보다 낮았다.

adam은 trianing loss와 validation loss가 같은 수준까지 낮아지는 모습이지만,

sgd는 training loss보다 validation loss가 더 낮은 수준까지 loss가 떨어졌다.

opptimizer로 sgd를 적합시켰을때, 20%의 validation을 제외한 training data로 학습을 한 것보다 20%의 validation의 loss가 더 낮았다는 원하는 결과가 도출되었다.